读论文资源
- 关于论文学习资源的合集论文学习资源合集
- CVPR2026的论文分布及follow 建议
- 一些可能有帮助的科研skill
选题思路
先由 问题地图 按「研究对象 → 核心能力 → 共同瓶颈 → 解决范式」为整个领域建图,形成整体认知;再到 Problem × Domain 矩阵 中统计同一个问题在不同领域里的分布,判断它是否跨领域反复出现;随后对每个候选问题做 Limitations 挖掘,从各篇论文的 limitation、discussion、future work 中提取作者明确承认却仍未解决的瓶颈并聚类;同时用 刷点风险指标 避开论文很多但高度同质化、只靠刷 benchmark 的红海方向;接着放到 论文四象限 里,用「研究活跃度 × 跨领域性」两个维度给问题定位,区分核心研究机会与潜在基础问题;最后由 博士选题候选指数 从广度、增长性、持续性、未解决程度、可进入性等维度综合打分,筛出博士课题候选集合。
待选topic
| Top | 方向 | 推荐度 | 理由 |
|---|---|---|---|
| 1 | VLM Efficiency | 9.5/10 | 最匹配你的算力。围绕 token pruning、量化、蒸馏、PEFT、推理加速,不需要从头训练 VLM;7B 级开源模型即可做出完整实验。 |
| 2 | 3D Vision | 9/10 | 尤其是 Gaussian Splatting、重建、Novel View Synthesis。很多工作单卡即可训练,8×3090 足够大规模跑 ablation,而且 CVPR 论文量最大、研究活跃。 |
| 3 | Image Restoration / Low-level Vision | 8.5/10 | 去噪、去模糊、超分、低光等实验成本低,公开数据集成熟,训练周期短,非常适合快速迭代方法。 |
| 4 | AIGC Detection / AI Safety | 8/10 | 算力门槛非常低,主要研究检测、鲁棒性、泛化、Deepfake 等;真正难点在问题设计而不是堆 GPU。 |
| 5 | Detection / Segmentation | 7.5/10 | MMDetection、Detectron2 等生态成熟,实验非常标准化;8×3090 完全够,但领域成熟,单纯刷结构创新较难。 |
| 6 | VLM Reasoning | 7/10 | 潜在影响力更高,可以基于 Qwen-VL/LLaVA 等做 LoRA、数据策略、推理方法;但实验成本和竞争强度明显高于前五。 |
-
顶级会议:
名称 方向 说明 NeurIPS ML · 多模态 表征学习、自监督学习论文的重镇;多模态表征学习常见于此。 ICML ML 机器学习综合顶会,表征学习论文数量大。 ICLR 表征学习 名称直接包含 Representations,表征学习论文最集中的会议之一。 CVPR CV 表征学习聚焦视觉领域的主场,包括对比学习和自监督视觉预训练。 ICCV CV 视觉领域顶会,自监督视觉预训练论文集中。 ECCV CV 视觉领域顶会。 ACL NLP NLP 表征学习,包括词向量、句子表征和预训练语言模型。 EMNLP NLP NLP 实证方法顶会,预训练语言模型论文密集。 NAACL NLP ACL 北美分会,NLP 表征学习论文集中。 AAAI AI 综合性人工智能顶会。 KDD 图 · 数据 偏应用和数据挖掘,图表征学习常见于此。 -
顶级期刊:
名称 方向 说明 JMLR ML 机器学习权威开源期刊。 TPAMI CV 视觉和表征学习方向权威期刊。 Nature Machine Intelligence ML Nature 旗下人工智能期刊。 Machine Learning ML Springer 机器学习期刊。 -
论文浏览与合集资源:
名称 类型 说明 papers.cool 论文浏览 按会议和年份浏览,支持关键词搜索和 PDF 下载;GitHub 仓库。 ICLR 2025 VizHub 可视化 将 ICLR 2025 论文按语义相似度映射到二维空间,支持交互式探索。 -
⚠️论文数据库的一些借鉴方向(待深入)
| 项目数据源的名称 | 完整度 | 数据量 | 维护频率 | 论文覆盖数量及覆盖范围 | 使用建议 |
|---|---|---|---|---|---|
| AI Paper Trends | ★★★★★:综合覆盖最强之一,包含顶会 + 顶刊 | 约 159,732 篇;161 个 venue-year;7,483 个细粒度 topic | 高频 + 自动更新基础设施;有 weekly check | 覆盖 2020–2026;包括 ICLR、ICML、NeurIPS、CVPR、ICCV、ECCV、ACL、EMNLP、AAAI、IJCAI、ICRA 等,以及 TPAMI、IJCV、TIP、PR、JMLR、TNNLS、TKDE 等顶刊 | 当前最值得作为跨 venue 基础索引之一;适合作为主库候选,但如果要完整 paper-level 原始字段,仍建议结合 OpenAlex / DBLP / OpenReview |
| Papers With Notes | ★★★★☆:覆盖多个主流会议,论文级信息丰富 | 约 26,673 条;CVPR 2026 页面约 4,367 条 | 中高频、会议事件驱动型 | 覆盖 CVPR、ICCV、ECCV、ICLR、ICML、ACL、AAAI、NeurIPS 等多个会议和年份;可带 Paper、Code、中文/英文 Notes、Oral / Spotlight / Highlight 等标签 | 高价值增强源;适合补 Code、Notes、论文等级和主题,但入库前需要对 venue/type 做去重和官方校验 |
| [CV_Paper_Portal](https://github.com/hongsong-wang/CV_Paper_Portal) | ★★★★★:历史跨度和会议覆盖非常强 | 未公布统一论文总数,但覆盖大量 conference-year 页面 | 高频、长期维护型 | CVPR 2013–2026、NeurIPS 2009–2025、ICML 2015–2026、ICLR 2017–2026、AAAI 2017–2026,并覆盖 ICCV、ECCV、ACL、EMNLP、ICRA、IROS、RSS、SIGGRAPH 等 | 非常适合作为历史补全源;优势是跨度大,缺点是结构化程度一般,需要自己写 extractor 和去重流程 |
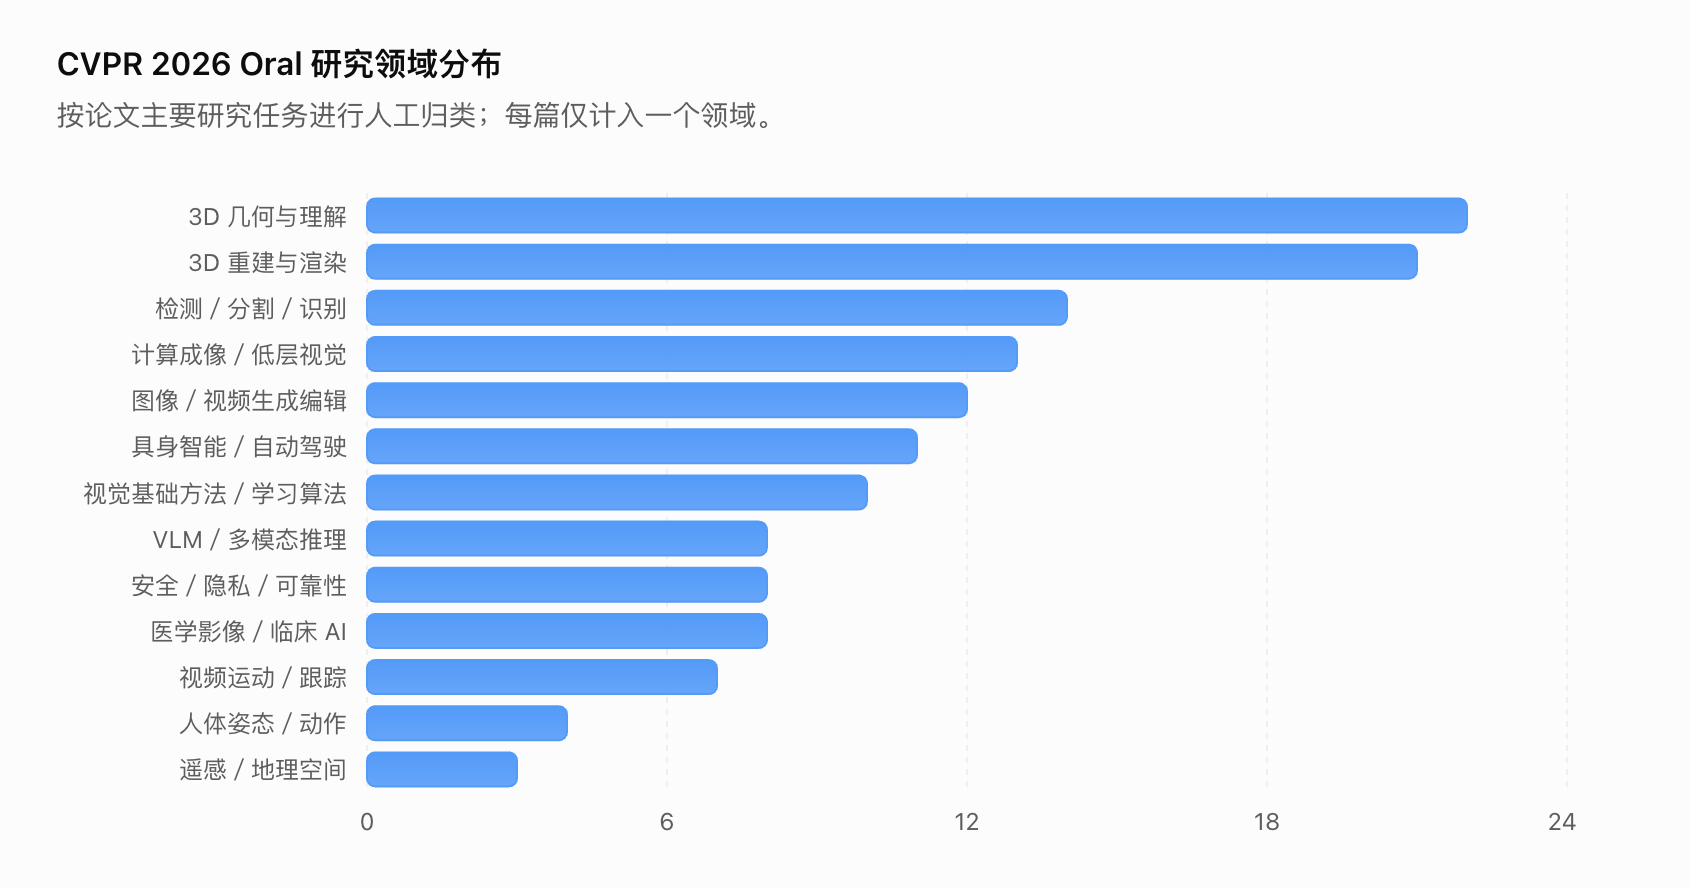
论文分布
| 大类 | 论文数 | 占比 |
|---|---|---|
| 视觉感知 | 1515 | 37.3% |
| 生成与多模态 | 1335 | 32.9% |
| 科学与跨学科 | 351 | 8.6% |
| 决策与具身 | 328 | 8.1% |
| 基础与理论 | 293 | 7.2% |
| LLM | 135 | 3.3% |
| 其他 | 105 | 2.6% |
| 合计 | 4062 | 100% |
| 排名 | 领域 | 数量 | 占比 |
|---|---|---|---|
| 1 | 3D 视觉 | 751 | 18.49% |
| 2 | 图像生成 | 490 | 12.06% |
| 3 | 多模态 VLM | 418 | 10.29% |
| 4 | 视频理解 | 187 | 4.60% |
| 5 | 视频生成 | 182 | 4.48% |
| 6 | 医学图像 | 172 | 4.23% |
| 7 | 自动驾驶 | 157 | 3.87% |
| 8 | 人体理解 | 151 | 3.72% |
| 9 | VLM Reasoning | 150 | 3.69% |
| 10 | 机器人/具身智能 | 146 | 3.59% |
| 11 | AI 安全 | 145 | 3.57% |
| 12 | 图像恢复 | 135 | 3.32% |
| 13 | 语义分割 | 122 | 3.00% |
| 14 | 模型压缩 | 108 | 2.66% |
| 15 | 其他 | 105 | 2.58% |
| 16 | 目标检测 | 99 | 2.44% |
| 17 | 自监督/表示学习 | 91 | 2.24% |
| 18 | VLM Efficiency | 63 | 1.55% |
| 19 | 遥感 | 63 | 1.55% |
| 20 | LLM Agent | 42 | 1.03% |
| 21 | 可解释性 | 34 | 0.84% |
| 22 | 幻觉检测 | 33 | 0.81% |
| 23 | 强化学习 | 25 | 0.62% |
| 24 | 音频/语音 | 22 | 0.54% |
| 25 | 优化/理论 | 22 | 0.54% |
| 26 | 计算生物 | 21 | 0.52% |
| 27 | 联邦学习 | 19 | 0.47% |
| 28 | LLM Reasoning | 16 | 0.39% |
| 29 | 对齐 / RLHF | 12 | 0.30% |
| 30 | LLM 安全 | 12 | 0.30% |
| 31 | AIGC 检测 | 10 | 0.25% |
| 32 | LLM 效率 | 8 | 0.20% |
| 33 | 图学习 | 8 | 0.20% |
| 34 | 异常检测 | 7 | 0.17% |
| 35 | 时间序列 | 7 | 0.17% |
| 36 | 预训练 | 5 | 0.12% |
| 37 | 因果推理 | 4 | 0.10% |
| 38 | LLM 其他 | 3 | 0.07% |
| 39 | 科学计算 | 3 | 0.07% |
| 40 | 社会计算 | 3 | 0.07% |
| 41 | Multi-Agent | 2 | 0.05% |
| 42 | 知识编辑 | 2 | 0.05% |
| 43 | 物理/科学计算 | 2 | 0.05% |
| 44 | 地球科学 | 2 | 0.05% |
| 45 | 信号/通信 | 2 | 0.05% |
| 46 | 医疗 LLM | 1 | 0.02% |
follow建议
| Top | 方向 | 推荐度 | 理由 |
|---|---|---|---|
| 1 | VLM Efficiency | 9.5/10 | 最匹配你的算力。围绕 token pruning、量化、蒸馏、PEFT、推理加速,不需要从头训练 VLM;7B 级开源模型即可做出完整实验。 |
| 2 | 3D Vision | 9/10 | 尤其是 Gaussian Splatting、重建、Novel View Synthesis。很多工作单卡即可训练,8×3090 足够大规模跑 ablation,而且 CVPR 论文量最大、研究活跃。 |
| 3 | Image Restoration / Low-level Vision | 8.5/10 | 去噪、去模糊、超分、低光等实验成本低,公开数据集成熟,训练周期短,非常适合快速迭代方法。 |
| 4 | AIGC Detection / AI Safety | 8/10 | 算力门槛非常低,主要研究检测、鲁棒性、泛化、Deepfake 等;真正难点在问题设计而不是堆 GPU。 |
| 5 | Detection / Segmentation | 7.5/10 | MMDetection、Detectron2 等生态成熟,实验非常标准化;8×3090 完全够,但领域成熟,单纯刷结构创新较难。 |
| 6 | VLM Reasoning | 7/10 | 潜在影响力更高,可以基于 Qwen-VL/LLaVA 等做 LoRA、数据策略、推理方法;但实验成本和竞争强度明显高于前五。 |
定义:
建立一个从“研究对象”到“核心问题”再到“解决方法”的多层次 AI 研究知识结构,用来形成对整个领域的整体认知。
推荐采用如下层级:
Layer 1:Domain
研究对象 / 领域

Language
Vision
Multimodal
Embodied AI
Robotics
Scientific AI
Structured Data

↓

Layer 2:Capability
核心能力

Perception
Generation
Reasoning
Retrieval
Memory
Planning
Control
Learning

↓

Layer 3:Problem
共同瓶颈

Generalization
Robustness
Uncertainty
Efficiency
Evaluation
Interpretability
Grounding
Long-horizon
Knowledge
Adaptation
Safety

↓

Layer 4:Method
解决范式

Scaling
Representation Learning
RAG
RL
Agent
World Model
Diffusion
Causal Learning
Symbolic Method
Test-time Adaptation
Memory核心思想:
博士选题不一定应该停留在:
“我要做 VLM”
“我要做 Agent”
“我要做 3D Vision”而更适合抽象成:
一个跨领域共同问题
+
一个新的解释框架 / 方法范式例如:
跨语言模型、视觉语言模型和 Embodied Agent 的可靠泛化问题或者:
长时序智能系统中的 Memory、Uncertainty 和 Error Accumulation 问题定义:
统计不同“共同问题(Problem)”在不同研究领域(Domain)中的分布情况,用于判断某个问题是否具有跨领域的普适性。
核心目的:
识别那些不仅存在于单一领域,而是在 CV、NLP、LLM、Multimodal、Robotics、RL、Scientific AI 等多个领域中反复出现的共同问题。
典型问题示例:
- Generalization / OOD
- Robustness
- Uncertainty
- Efficiency
- Evaluation
- Long-horizon Reasoning
- Memory
- Grounding
- Continual Adaptation
主要价值:
帮助区分“领域特定问题”和“跨领域基础问题”,从而优先寻找更具有通用研究价值的博士课题。
定义:
从论文中的 limitation、discussion、future work、failure case 等内容中提取作者明确承认的未解决问题,并对这些问题进行聚类和统计。
核心思路:
例如不同论文可能分别写:
- poor generalization to unseen domains
- performance drops under distribution shift
- limited transferability
- fails on unseen categories
虽然表达不同,但本质上可能都属于:
OOD / Generalization因此可以将大量论文的 limitation 聚合成一套“共同失败模式”。
重点分析:
- 哪些 limitation 出现频率最高
- 哪些 limitation 连续多年存在
- 哪些 limitation 横跨多个领域
- 哪些 limitation 已经有大量论文研究但仍未解决
主要价值:
相比“论文在研究什么”,limitations 更直接反映:
当前整个领域真正解决不了什么。
这可能是发现长期基础研究问题的重要入口。
定义:
衡量一个研究方向是否已经进入高度同质化、benchmark 驱动、局部性能优化为主的阶段。
可以统计的指标包括:
- Benchmark 集中度
- Dataset 集中度
- Evaluation Metric 集中度
- 方法结构相似度
- 平均性能提升幅度
- SOTA 更新频率
- 方法贡献是否集中在局部模块修改
- 是否大量出现 new loss / new module / new architecture
- 理论分析、机制研究和 failure analysis 的比例
典型高风险特征:
大量论文
+ 使用相同数据集
+ 使用相同指标
+ 方法高度相似
+ 性能提升只有 0.x%这可能意味着该方向已经形成成熟的“刷榜范式”。
主要价值:
帮助避免进入论文很多、竞争激烈,但主要依靠工程调参和局部优化的研究方向。
定义:
用两个核心维度将研究问题放到二维空间中,从而判断不同问题的研究价值和定位。
一个推荐的二维坐标是:
-
横轴:Research Activity / Growth
- 当前论文数量
- 近几年增长速度
-
纵轴:Cross-domain Generality
- 问题横跨多少领域
- 是否具有普适性
形成四个象限:
| 研究活跃度低 | 研究活跃度高 | |
|---|---|---|
| 跨领域性高 | 潜在基础问题 | 核心研究机会 |
| 跨领域性低 | 小众问题 | 热门领域问题 |
重点关注两个象限
右上角:
高跨领域性
+
高研究活跃度代表已经形成明显领域共识的重要问题。
左上角:
高跨领域性
+
当前研究量较少可能代表尚未充分开发的基础研究机会。
主要价值:
防止简单地把“论文最多”等同于“最值得研究”,而是同时考虑研究热度与问题普适性。
定义:
为潜在研究问题构建一个综合评分体系,从多个维度评价其是否适合作为博士阶段长期研究方向。
可以考虑如下维度:
- Breadth(广度):问题覆盖多少领域、多少顶会
- Growth(增长性):相关论文占比是否持续增长
- Persistence(持续性):问题是否连续多年存在
- Fragmentation(碎片化程度):现有解决方案是否高度分散
- Unsolvedness(未解决程度):论文是否持续重复提到相同 limitation
- Feasibility(可进入性):普通实验室是否能够开展研究
- Scientific Depth(科学深度):是否存在值得解释的机制性问题
可以形成类似:
Topic Score
= Breadth
× Persistence
× Unsolvedness
× Scientific Depth
× Feasibility主要价值:
避免单纯依据“热门程度”选方向,而是从长期性、通用性、未解决程度和研究深度等方面系统评估博士课题。